KV Cache 量化算子:KIVI
[ICML 24]KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
本文会依照论文叙述顺序,从实际问题入手,完成量化需求挖掘、设计量化策略、实现对应算子的整个路径。
Introduction
KV Cache 是大模型自回归推理中的关键机制。对于每一层 Attention,模型会缓存历史 Token 对应的 Key 和 Value 激活;生成新 Token 时,只需计算当前 Token 的 Query、Key 和 Value,并复用历史 K/V,从而避免重复计算。
但随着序列长度、Batch Size、层数和 KV Head 数增长,KV Cache 会线性占用更多显存,并带来持续的 HBM 读写压力。于是,原本用于加速推理的 Cache 可能成为显存容量和访存带宽瓶颈。
Warning
540B PaLM 模型在进行 batchsize=512 contextlength=2048 推理时,产生的 KV cache 占用可以高达 3TB。
有关 KV Cache 的技术细节,请参考:llm-algo-leetcode-KV Cache 和 KV Cache 原理及代码解析
观察 KV Cache 的显存占用计算公式(FP16 每个元素占用 2 个字节):
可见影响 KV Cache 占用的因素有很多,模型架构(Transformer 层数,K/V 注意力头数)、数据规模(Batch size、Sequence length)以及存储的数据格式(Per element bytes)。这也指示了优化的不同方向,比如针对模型架构的 MQA、GQA 等改良注意力机制,通过减少 K/V 的独立计算头数来减少产生的缓存量;还有一些看起来很 Fancy 的手段:跨层共享、Token 融合,都能够从不同角度优化缓存占用。这些‘大刀阔斧’的改动或多或少都会对模型架构进行改动,以至于当我们希望在一个确定的模型上进行优化时,不能沿用它们。
Paged Attention 借鉴操作系统分页原理,同样不改动模型,只是把 KV Cache 切成固定大小的块,通过映射表按需存取。是推理优化时最直接、最有效的手段之一。
那么,既然在一次推理过程中,总是有确定的 batchsize 和 seq_len,且模型本身架构也不能调整,上式中能被调整的就只剩下 每个元素的存储占用 Per Element Byte了。
你知道我们会做什么:量化!当激活值从 FP16 降为 INT8,单个元素的占用减半,进而整块缓存占用也能减半。量化总是有代价的,假如简单粗暴地对 KV Cache 进行固定区间量化,随着表示精度的降低,量化误差也会增大。必须考虑一种合理的量化方案,在尽可能保证精度的前提下缩小 Cache 占用。
Step 1: Analyze
如何设计量化方案是一门学问,就像压制常常会降低视频的清晰度一样,将 FP16 的数据降为低比特格式时,会带来无法避免的信息丢失,设计一个适合待量化数据的方案尤为重要,尽可能地减小损失。以下图中的张量为例,简述几种常见的 Min-Max 量化路径:
Note
给定一组数据 X 和量化比特位数 N,可知在 INTN 表示下,可以有 \(2^N\) 个有效数值,通过计算量化步长 \(s = \frac{\max(X) - \min(X)}{2^N}\) 就可以将原来的浮点数映射到有限的有限数值上: \(X_{q} = \text{clamp}(\text{round}(\frac{X-\min(X)}{s}))\) 。
常见的量化手段有 Per-Tensor, Per-token, Per-Channel 三种情况,分别表示沿着张量的不同方向取参考区间。其中,Per-Tensor 表示在整个 Tensor 范围内取最大最小值来确定量化区间,后面二者则是沿着行、列的方向单独统计。不难看出,在量化位数一定的情况下,区间内极差越大,量化步长就会越大(为了在有限步数中覆盖更大的数值范围),每个量化格点的表示能力就越模糊,容易出现更多原本不同的值被映射到相同的格点上,带来更大的信息损失。在应用场景中,没有一定‘哪种最好’的概念,需要根据待处理的 Tensor 自身数值特征来确定。
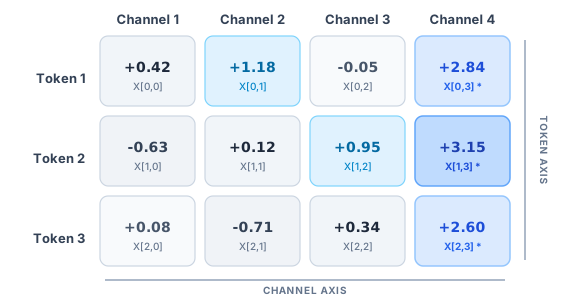
沿着每一行观察样例 Tensor,会发现每个 Token 在不同维度上的数值总是波动很大;沿着每一列观察 Tensor,会发现虽然也会出现较大变异的数值(离群点),但相比行方向,已经表现出了一定的规律:尤其是 Channel 4。这就说明在这种情况下,Per-Channel 会比 Per-Token 量化数值上更加稳定。
既然如此,对 KV Cache 的数值分布情况分析也是必要的,这是 KIVI 作者在论文中呈现的结果:
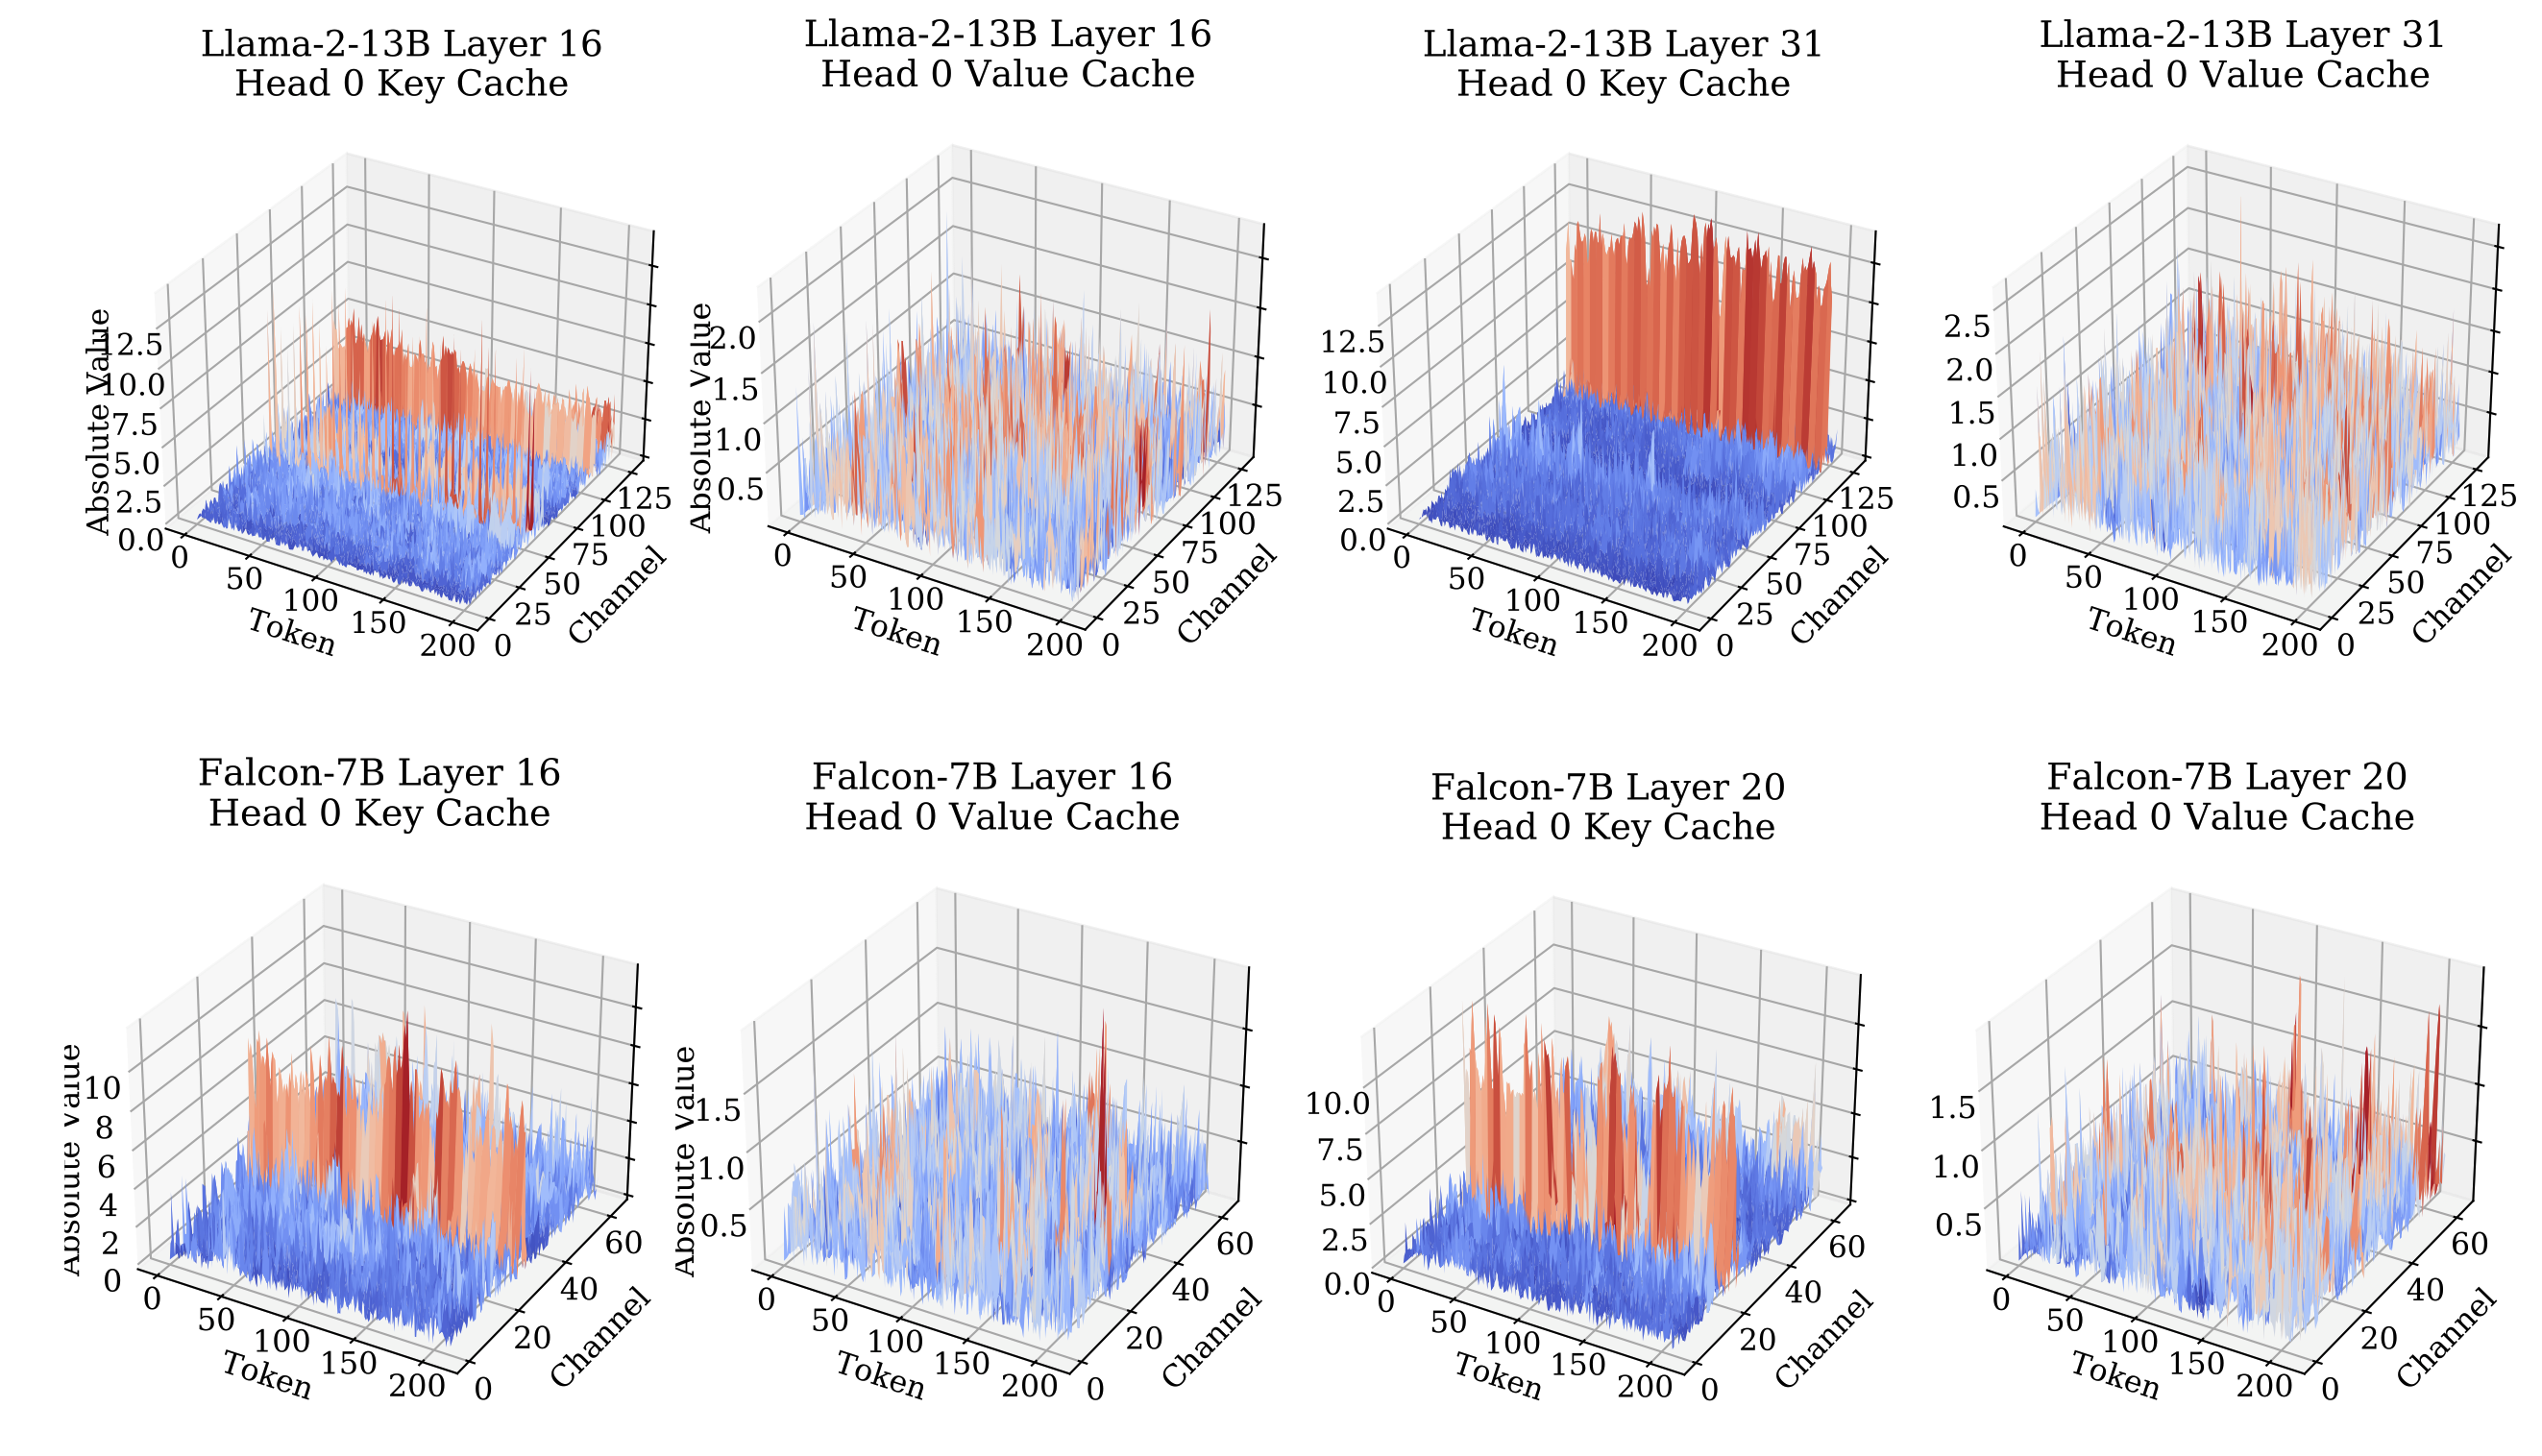
"We observe that in key cache, some fixed channels exhibit very large magnitudes, whereas in value cache, there is no significant pattern for outliers."
既然 K 和 V 表现出了不同的数值特性,那就自然地尝试将它们分别沿着更稳定的维度量化:K - Per Channel, V - Per Token. 先把已经确定要尝试的方案敲成代码。这里额外使用了分组量化的逻辑,简单来说就是在沿着方向划分张量的同时,不一次性沿着这个方向取出所有数值,每次只整合 group_size 个元素。对于 Per Channel 的 K ,在特定 Channel 上每组包含了 group_size 个 Token 的该 Channel 数值,组内共享一组量化参数,以更细粒度地保障数值稳定性。对于 V 的 Per Token 量化,过程类似不再赘述。
def quant_kcache(k: torch.FloatTensor, group_size: int, bits: int):
    assert len(k.shape) == 4
    shape = k.shape
    B, nh, T, D = shape

    assert T % group_size == 0
    num_groups = T // group_size
    new_shape = (B, nh, num_groups, group_size, D) # Token 分组

    max_int = 2 ** bits - 1
    data = k.view(new_shape)
    mn = torch.min(data, dim=-2, keepdim=True)[0]
    mx = torch.max(data, dim=-2, keepdim=True)[0]
    scale = (mx - mn) / max_int # 步长
    data = data - mn # 归一化
    data.div_(scale)
    data = data.clamp_(0, max_int).round().to(torch.int32) # 映射

    data = data.view(shape)
    code = pack_tensor(data, bits, pack_dim=2) # 我们稍后会讲到。
    return code, scale, mn
Step 2: Simulate
目前为止,这只能算是实现了量化的第一步:模拟映射。为什么是模拟?请注意我们的 quant 函数将 torch.float16 数值映射到了 torch.int32 格式,尽管在数字范围上,确实表示它们用了更少的位数,但实际的占用不减反增,每个元素占用的字节从 2 bits 翻倍成 4 bits,并且还引入了不少 fp16 的量化缩放参数。不过好消息是,量化后的张量数值确实被压缩到了我们指定的位数表达范围内,比如指定 bits=2 ,可用的整数值就只有 0, 1, 2, 3,即便它们是 int32,无非是一长串 0 后面跟两个有效位(不考虑符号的情况下)。
所以接下来要做的,就是真正让存储省下来。一个 int32 元素有 32 个单元格,每个有效元素只使用其中 2 个,相当于原来一个元素的位置可以塞进去 32 / 2 = 16 个量化元素!如何做到这一点也并不复杂,我们用 pack_tensor() 每次给 16 个量化元素分配 32 个格子中的其二,让他们按顺序排铺开,这样就实现了用一个 int32 元素实际容纳 16 个 int2 元素。
def pack_tensor(data, bits, pack_dim)
    shape = data.shape
    feat_per_int = 32 // bits
    assert bits in [2,4,8], "Only 2, 4, 8 bits are supported"
    assert shape[pack_dim] % feat_per_int == 0, "Dimension length must be divisible by number of features per int"

    code = torch.zeros(shape[:packdim] + (shape[pack_dim] // feat_per_int,) + shape[pack_dim+1:],
                    dtype=torch.int32,
                    device=data.device)
    i = 0
    row = 0
    unpacked_indices = [slice(None)] * len(data.shape) # 指向待打包元素
    packed_indices = [slice(None)] * len(data.shape) # 指向已打包容器
    while row < code.shape[pack_dim]:
        packed_indices[pack_dim] = row # 每次打包 1 个int32容器
        for j in range(i, i + (32 // bits)):
            unpacked_indices[pack_dim] = j # 每次取 1 个元素
            code[packed_indices] |= data[unpacked_indices] << (bits * (j - i))
        i += 32 // bits # 下一批元素
        row += 1 # 下一个容器
    return code
有了存进去的操作,在运算时也需要从容器中取出来,unpack_tensor 就是 pack_tensor 的反向操作,代码就不展开讨论了。
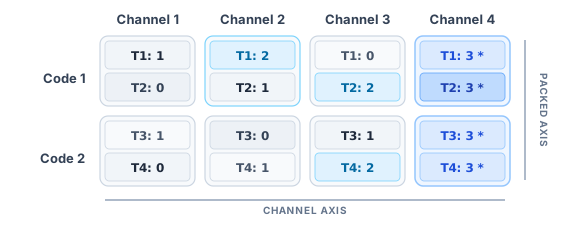
这里标记一下 pack_dim 这个概念。代码中可以看出,data 的形状是 [B, nh, T, D] 的,沿 Token 维度 Pack,在 2-bit 情况下每 16 个 Token 的量化 code 被编码到一个 int32 中,物理形状变为 [B, nh, T/16, D],但逻辑上仍然表示原来的 T 个 Token。这里的 T/16 来自 feat_per_int=32//bits,表示存储 word 数量的减少
Step 3: Design
现在,我们成功实现了一条低比特存储路线,也已经可以通过推理时的数值变化情况评估设计的方案效果,可也只是实现了存储部分。在当前的模型进行计算时,仍然不得不进行 int2 packs - unpack - dequant - fp16 torch.matmul,相比原来的 fp16 tensors - torch.matmul 正常推理过程还多了额外的解包、反量化和各种 Tensor 搬运的开销,因此推理效率反而会更慢。这一切都是因为我们自创了一个非标准的 packed code 数据结构,它不被任何运算单元熟悉,只能先被转换为支持的数据类型再送入单元运算。
因此,必须设计并实现在运算层面生效的算子,使 GPU Kernel 可以直接接受 packed code + quant scales,能像进行浮点数矩阵乘法一样原生地支持自定义的运算方式。
教程 Triton 章节 中深入介绍了基于 Block 编程的高性能算子实现中间层工具,我们在此就使用这一工具实现上述量化方案的算子,真正走向高性能的低比特存储和计算。
前文讨论的 min-max quant, pack 函数均需要重做 triton 版本以提供高性能支持,但实现逻辑相差不大,就不再展开,具体请参考代码;而负责解包、反量化的 unpack, dequant 函数则不再被需要,这两个过程需要被整合到矩阵乘法算子中,使之能直接接受量化数值并在内部解包、反量化、计算。
我们重点关注处理量化张量的矩阵乘法算子,它本质上仍然做的是 \(C = A \times B\) 乘法,但在量化 kv cache 的前向过程中,传入算子的 A, B 分别是 fp16 Tensor 和 packed low-bit Tensor;为了在内部执行反量化,与量化相关的参数也要被传入:scales, mn, mx, bits, group_size。在算子内部,会一边根据量化参数复原被打包的低比特数据到浮点精度,一边进行浮点精度的矩阵乘法计算,还要确保让运算和搬运同时进行,避免性能浪费。(实际上这时就不存在独立的 Dequant 过程,也不会产生需要较长时间暂存的大规模 fp16 中间数值。)
另外,在 Attention 中,实际运行了两轮矩阵乘法:\(A = Q \times K^T\) 和 \(O = A \times V\) 在我们前面的量化假设下,KV 都保持了相同的 2-bit 精度,这两轮乘法可以看作是同样的 [fp16] matmul [packed int2] 精度乘法,只需要设计一个统一算子,在不同调用时传入不同参数,且矩阵的尺寸会发生变化。
在 Prefill 阶段,输入包含多个 Token,Attention 计算具有较大的矩阵维度,KIVI 仍使用 FP16 matmul 或 FlashAttention 完成主要计算;计算结束后,再将已经生成的 KV Cache 划分为低比特部分和 FP16 residual 部分。进入 Decode 阶段后,每次只处理一个新 Token,历史 KV Cache 成为主要的显存和访存瓶颈,此时通过 qbvm_kernel 直接读取 packed low-bit 数据,在 kernel 内完成解包、反量化和点积累加,从而避免显式恢复完整 FP16 Cache。也就是说,KIVI 的低比特算子重点优化的是 Decode 阶段,而 Prefill 阶段负责生成并初始化这份压缩 Cache。
一个较好的算子会采用 Python Wrapper + GPU kernel 的分层设计,分别负责计算流程的不同阶段: 1. Wrapper 负责前期整理:准备参数,设定配置,启动 kernel。 2. Kernel 执行实际运算:管理线程,纯粹的计算。
考虑到尝试传入算子的还包含不同量化配置下的特定量化参数,有必要也采取这样的分层设计,让外层 Wrapper 接管顶层 Torch 传入的 fp Tensor 和 packed int Tensor,整理成合适规格后与参数一起递交 kernel 启动运算。
def triton_bmm_fA_qB_outer(group_size: int,
                        fA: torch.FloatTensor,
                        qB: torch.IntTensor,
                        scales: torch.FloatTensor,
                        zeros: torch.FloatTensor,
                        bits: int) -> torch.FloatTensor:
    # Compute matrix: C = query x key
    # fA: (B, nh, M, K) fp16
    # qB: (B, nh, K, N // feat_per_int) int32
    # scales: (B, nh, K, G) fp16
    # zeros: (B, nh, K, G) fp16
这里传入的 qB 应是已经过转置的 K 矩阵,因此打包后的 Token 维度变为了最后一维,同时量化参数 scales 与 zeros 也保持与 qB 的分组布局对应。第一步要先还原出 B 中实际有多少个元素,这里不需要真正解包,只算出数量好让后续算子知道总数即可;然后遵循批量矩阵运算的逻辑,保留最后两个维度展平张量的批次 B 和注意力头数 nh,算子会接收分块后的后两个维度数据进行元素乘和累加。
def triton_bmm_fA_qB_outer(...):
    B, nh, M, K = fA.shape

    feat_per_int = 32 // bits
    N = qB.shape[-1] * feat_per_int # 解包后的尺寸
    flatten_B = B * nh

    fA = fA.view(-1, M, K)
    qB = qB.view(-1, K, qB.shape[-1]) # 展平
    scales = scales.view(flatten_B, scales.shape[-2], scales.shape[-1])
    zeros = zeros.view(flatten_B, zeros.shape[-2], zeros.shape[-1])
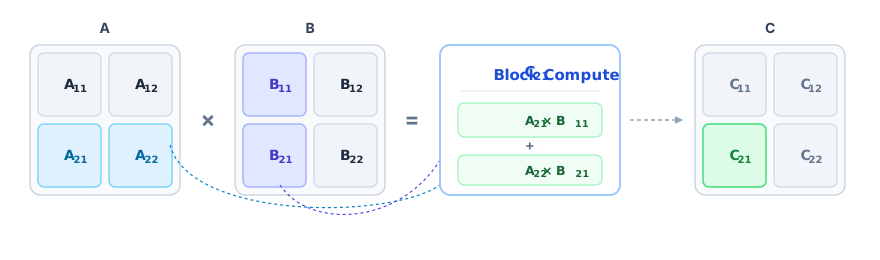
这个逻辑讲起来很通顺直观,也正是 triton 的设计逻辑,在使用 triton 实现算子时,实际上关心的是如何分块、每个块上如何计算,用同一种写法‘广播’到每个子块上,他们全都会进行相同的行为,自动完成并行计算的过程。所以我们看一下在使用 KV Cache 的情况下进行一批单 Token Decoing 的过程中,哪些过程是可并行的、我们想让算子做什么:
在 Decode 阶段,针对单个 Token 的 Attention 计算中,Query 的长度为 M=1。这意味着所谓的矩阵乘法 \(Q \times K^T\),本质上退化成了 n=1 的向量矩阵乘法。因此,我们的 Triton 算子目标非常明确:
-
Grid 并行切分:将 Batch 与 Head 的组合
flatten_B = B * nh以及 Key 的历史 Token 维度(N)切分成若干个并行处理的 Block。每个 Block 负责计算当前 Query 向量与局部历史 Key 向量切片的点积。 -
K 维循环累加:沿隐藏维度 K 以 BLOCK_K 为步长进行循环。在片上(SRAM)分块读取低比特量化的 Key、解包、反量化为 FP16,并与分块读取的 Query 执行乘与累加。
下面我们补全 Wrapper 的后半段逻辑:分配输出 Tensor、定义网格配置并启动 Kernel。
def triton_bmm_fA_qB_outer(
    group_size: int,
    fA: torch.FloatTensor,
    qB: torch.IntTensor,
    scales: torch.FloatTensor,
    zeros: torch.FloatTensor,
    bits: int,
) -> torch.FloatTensor:
    B, nh, M, K = fA.shape

    feat_per_int = 32 // bits
    N = qB.shape[-1] * feat_per_int  # 恢复出逻辑 Token 序列长度
    flatten_B = B * nh

    fA = fA.contiguous().view(flatten_B, M, K)
    qB = qB.contiguous().view(flatten_B, K, -1)
    scales = scales.contiguous().view(flatten_B, scales.shape[-2], scales.shape[-1])
    zeros = zeros.contiguous().view(flatten_B, zeros.shape[-2], zeros.shape[-1])

    # 输出 C: [flatten_B, M, N],此处 M = 1
    c = torch.empty((flatten_B, M, N), device=fA.device, dtype=fA.dtype)

    # 块划分超参数
    BLOCK_M = 16  # Query 维度通常补齐到 16 满足硬件对齐
    BLOCK_N = 64  # 每个 Block 负责计算 64 个 Key Token 的点积
    BLOCK_K = 32  # 隐藏维度每次迭代步长

    # 定义 2D Grid: (M 维方向块数, N 维方向块数, Batch * Heads)
    grid = (
        triton.cdiv(M, BLOCK_M),
        triton.cdiv(N, BLOCK_N),
        flatten_B,
    )

    _qbvm_kernel_fA_qB[grid](
        fA, qB, c,
        scales, zeros,
        M, N, K,
        # Strides 参数传入,用于计算硬件显存指针偏移
        fA.stride(0), fA.stride(1), fA.stride(2),
        qB.stride(0), qB.stride(1), qB.stride(2),
        c.stride(0), c.stride(1), c.stride(2),
        scales.stride(0), scales.stride(1), scales.stride(2),
        zeros.stride(0), zeros.stride(1), zeros.stride(2),
        group_size=group_size,
        bits=bits,
        BLOCK_M=BLOCK_M,
        BLOCK_N=BLOCK_N,
        BLOCK_K=BLOCK_K,
    )

    return c.view(B, nh, M, N)
Step 4: Kernel
现在可以开始实现执行计算的核心了:编写 Triton Kernel 时,重点关注坐标系统与指针偏移计算,每个 Kernel 会在被分配到每个执行实例上后(Program instance)通过 tl.program_id 获取自身所处的块索引,并以此生成当前线程块负责加载的数据地址掩码,进一步获取计算所需的块数据。
对于我们要实现的低比特 Kernel 来说,和普通的计算流程唯一的不同点就是 Global Memory 里的 B 矩阵是按 int32 紧凑打包的,每个 32-bit 寄存器装了 16 个 2-bit 数据。如何让 Kernel 能够直接使用读取的 int32 数据自行解包执行运算,说最核心的问题。
先来看看单个量化值如何在寄存器内还原:
对于 INT2,应表现出仅有两位有效数值,因此掩码(Mask)是 0x3。每个元素从最低位开始各占用两个有效位,在打包时按次序推入 32 位存储容器,第 j 个元素的真实低比特值就是 (packed_val >> (j * bits)) & mask。还原出整数之后,再与对应的 scale 和 zero 结合,反量化出浮点数。
知道了单个量化值如何恢复,接下来就要让这个过程在每个计算块上执行。Wrapper 将 Batch 和 Head 合并后,按 grid=(flatten_B, triton.cdiv(N, BLOCK_N)) 启动算子。每个 program 处理一个 Batch/Head 下连续的 BLOCK_N 个输出位置,至于每个位置需要沿 K 累加多少次,则由 program 内部的循环完成。这样分工的好处是,各个 program 的输出区域互不重叠,不需要在计算结束后再合并多个 program 的部分和。
pid_batch = tl.program_id(axis=0)
pid_n = tl.program_id(axis=1)

feat_per_int = 32 // bits
offs_n = pid_n * BLOCK_N + tl.arange(0, BLOCK_N)
offs_k = tl.arange(0, BLOCK_K)

# 定位当前 Batch/Head 的起点
a_ptr = a_ptr + pid_batch * stride_abatch
b_ptr = b_ptr + pid_batch * stride_bbatch
c_ptr = c_ptr + pid_batch * stride_cbatch
scales_ptr = scales_ptr + pid_batch * stride_scales_b
zeros_ptr = zeros_ptr + pid_batch * stride_zeros_b

# 逻辑输出列对应的存储容器、bit 槽位和量化分组
packed_n = offs_n // feat_per_int
shifter = (offs_n % feat_per_int) * bits
group_n = offs_n // groupsize
bit_mask = (1 << bits) - 1

accumulator = tl.zeros((BLOCK_N,), dtype=tl.float32)
这里的 offs_n 是当前 program 负责的逻辑输出列,比如 pid_n=1、BLOCK_N=64 时,它包含的就是 [64,65,...,127]。对于普通矩阵,我们可以直接用这些列坐标读取元素,但 packed 矩阵需要再走一步:先找到容器,再找到容器内的槽位。因此代码中同时保留了 packed_n 和 shifter,前者决定读取哪个 int32,后者决定从中取出哪几个 bit。以 2-bit 的逻辑列 19 为例,19//16=1,说明它在第 1 个 int32 中;(19%16)*2=6,说明需要右移 6 位再与 0011 做按位与。
有了这些坐标,就可以沿 K 维度分批读取数据。对于 QK 计算,K 对应 Head Dimension,每一轮读取一部分 Channel;对于 AV 计算,K 对应历史 Token 数,每一轮读取一部分 Token。虽然含义不同,但是计算形式是一致的:取出 [BLOCK_K,1] 的 A 和逻辑上 [BLOCK_K,BLOCK_N] 的 B,恢复 B 的浮点数值后,逐元素相乘,再沿第一维求和,得到当前 K 分块对 BLOCK_N 个输出位置的贡献。
至此,我们终于得到了完整的自定义 Kernel 代码:
for pid_k in range(0, tl.cdiv(K, BLOCK_K)):
    k = pid_k * BLOCK_K + offs_k
    valid_b = (k[:, None] < K) & (offs_n[None, :] < N)

    a_ptrs = a_ptr + k[:, None] * stride_ak
    b_ptrs = (
        b_ptr
        + k[:, None] * stride_bk
        + packed_n[None, :] * stride_bn
    )
    scale_ptrs = (
        scales_ptr
        + k[:, None] * stride_scales_k
        + group_n[None, :] * stride_scales_g
    )
    zero_ptrs = (
        zeros_ptr
        + k[:, None] * stride_zeros_k
        + group_n[None, :] * stride_zeros_g
    )

    a = tl.load(a_ptrs, mask=k[:, None] < K, other=0.0)
    b_packed = tl.load(b_ptrs, mask=valid_b, other=0)
    scale = tl.load(scale_ptrs, mask=valid_b, other=0.0)
    mn = tl.load(zero_ptrs, mask=valid_b, other=0.0)

    # 解包、反量化后立即参与计算
    b_int = (b_packed >> shifter[None, :]) & bit_mask
    b = b_int * scale + mn
    accumulator += tl.sum(a * b, axis=0)
走到这里,前面设计的 packed 数据格式终于有了与之配套的计算过程:量化整数以紧凑形式保存在显存里,Kernel 每次只读取当前块需要的部分,在片上完成解包和反量化,随后立即参与乘法与归约。相比先恢复整份 FP16 Cache 再调用矩阵乘法,这条路径省去了完整反量化张量的显存写入和再次读取,也把原来多个独立操作的启动开销合并到一次 Kernel 调用中。但压缩比例并不等于加速比例,实际收益还取决于 scale 和 mn 的访存、位运算开销、块大小以及 GPU 资源占用。至此,我们完成了一条能直接消费低比特 KV Cache 的算子实现。